LibreNMS 警報相關設定
LibreNMS 警報相關設定
- LibreNMS LINE Messaging API 設定
- LibreNMS Mdadm RAID監控警報
- LibreNMS 硬碟使用率監控警報
- LibreNMS CPU使用率監控警報
- LibreNMS ICMP 監控警報
- LibreNMS 自訂 LVM-Thin Pool 監控
- LibreNMS 自訂CPU溫度監控警報
LibreNMS LINE Messaging API 設定
運行環境
- Librenms 25.9.0
LINE Messaging API 申請
先在LINE Developers新增一個channel並選擇Messaging API

設定警報傳送
Type選擇LINE Messaging API
Access token輸入Channel access token
userID輸入Channel 內的user ID

設定好後點選右邊Test,LINE有出現測試訊息則成功

LibreNMS Mdadm RAID監控警報
啟用Mdadm
確認已安裝Mdadm監控
新增警報規則
Severity:警報等級
Max alert :最多通知幾次
Delay :延遲多久再來通知
Interval :通知間隔
Transports:選擇傳送類別
範例監控RAID降級後1分鐘發出警報

新增警報範本
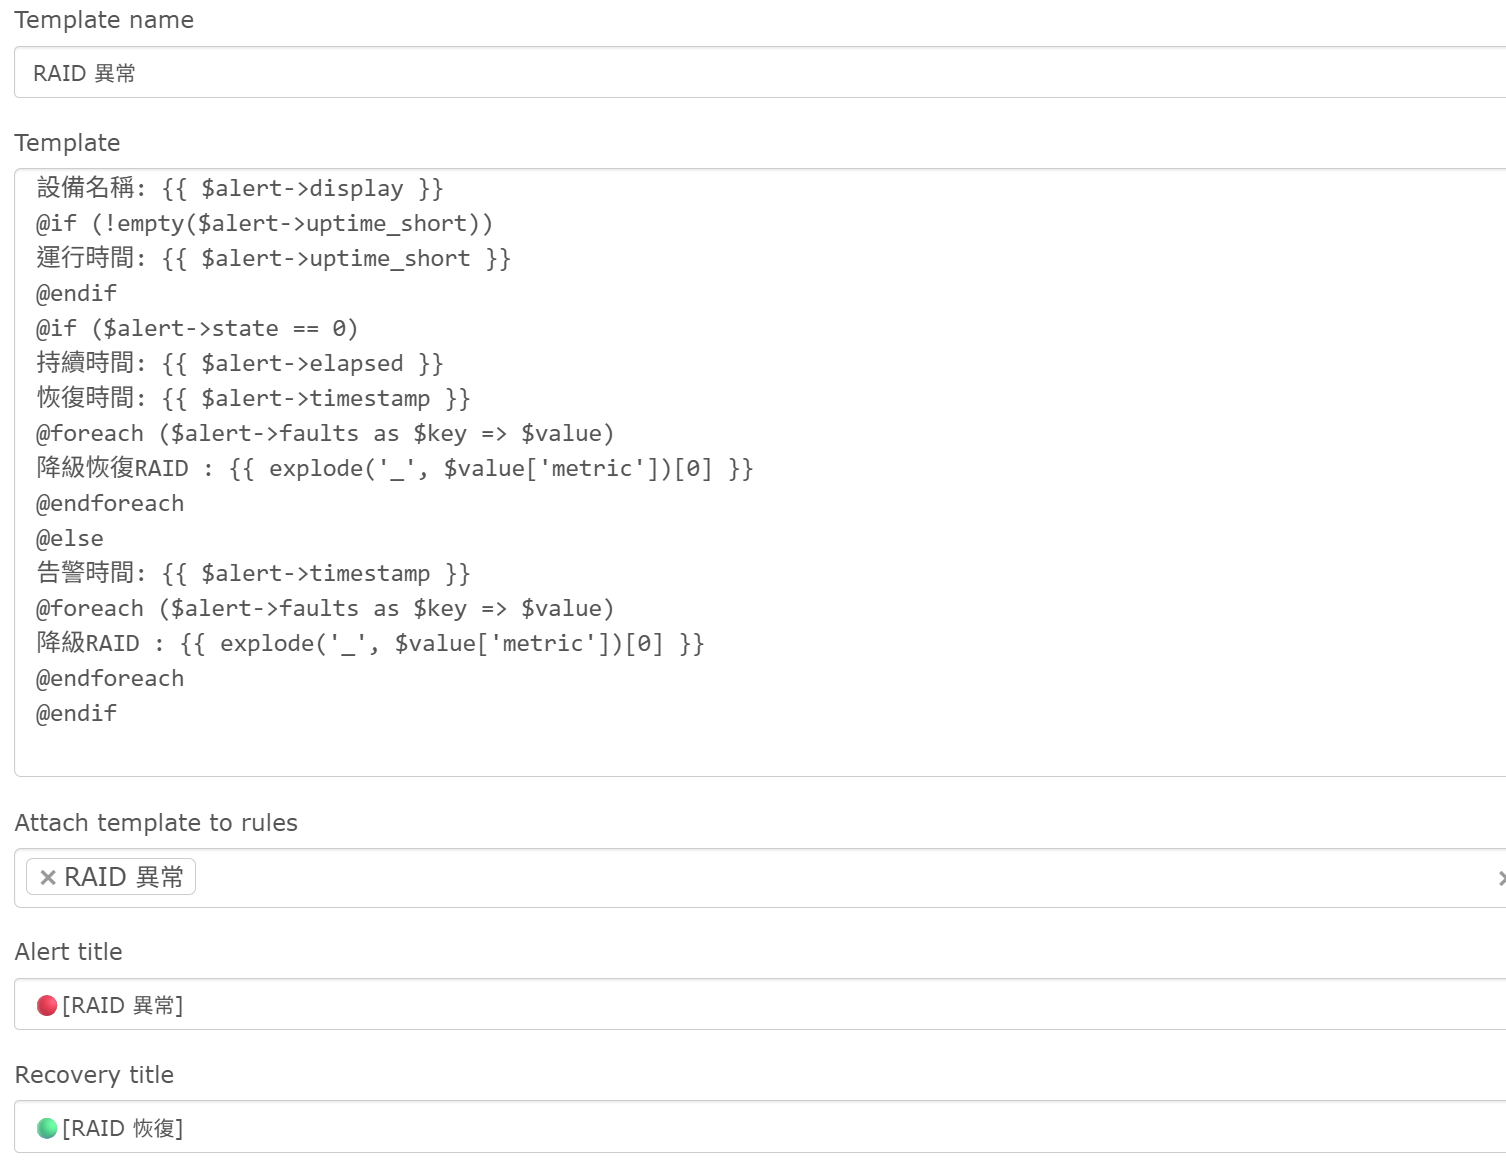
{{ $alert->title }}
設備名稱: {{ $alert->display }}
@if (!empty($alert->uptime_short))
運行時間: {{ $alert->uptime_short }}
@endif
@if ($alert->state == 0)
持續時間: {{ $alert->elapsed }}
恢復時間: {{ $alert->timestamp }}
@foreach ($alert->faults as $key => $value)
降級恢復RAID : {{ explode('_', $value['metric'])[0] }}
@endforeach
@else
告警時間: {{ $alert->timestamp }}
@foreach ($alert->faults as $key => $value)
降級RAID : {{ explode('_', $value['metric'])[0] }}
@endforeach
@endif
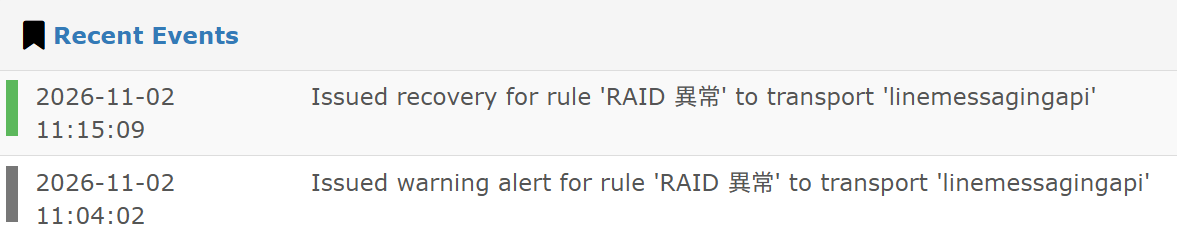
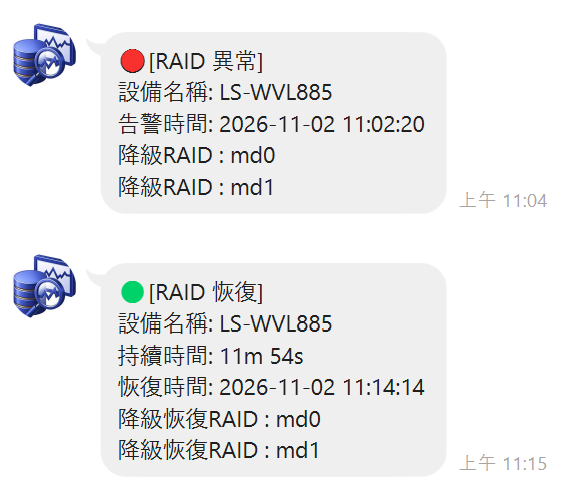
測試
LibreNMS 硬碟使用率監控警報
新增警報規則
範例監控"/"根目錄使用率超過80%
Severity:警報等級
Max alert :最多通知幾次
Delay :延遲多久再來通知
Interval :通知間隔
Transports:選擇傳送類別

新增警報範本

{{ $alert->title }}
設備名稱: {{ $alert->sysName }}
等級: {{ $alert->severity }}
運行時間: {{ $alert->uptime_short }}
警示時間: {{ $alert->timestamp }}
@foreach ($alert->faults as $key => $value)
硬碟名稱: {{ $value['storage_descr'] }}
目前硬碟使用率: {{ $value['storage_perc'] }} %
@endforeach
測試


LibreNMS CPU使用率監控警報
新增警報規則
Severity:警報等級
Max alert :最多通知幾次
Delay :延遲多久再來通知
Interval :通知間隔
Transports:選擇傳送類別
範例使用CPU>70%持續10分鐘發出警報
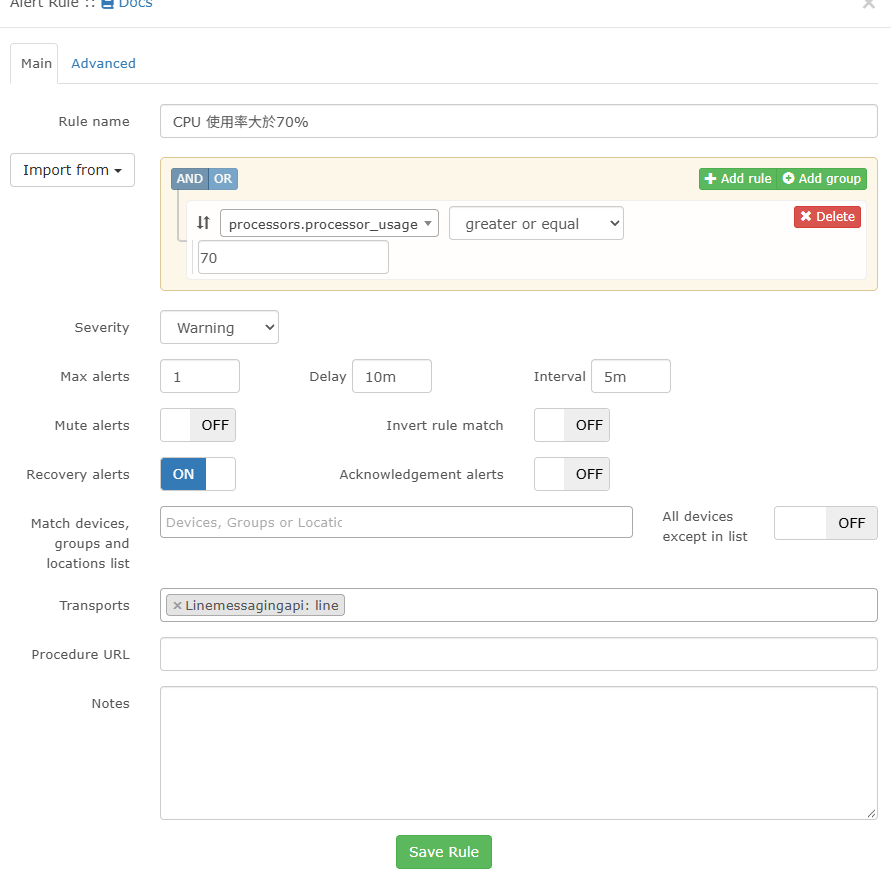
由於多核心CPU預設一顆CPU觸發就會警報,故修改使用平均使用率計算
官方解決範本https://docs.librenms.org/Alerting/Rules/#advanced,不過有GROUP語法錯誤告警
以下為自訂修改版本搭配警報範本使用,Override SQL記得開啟
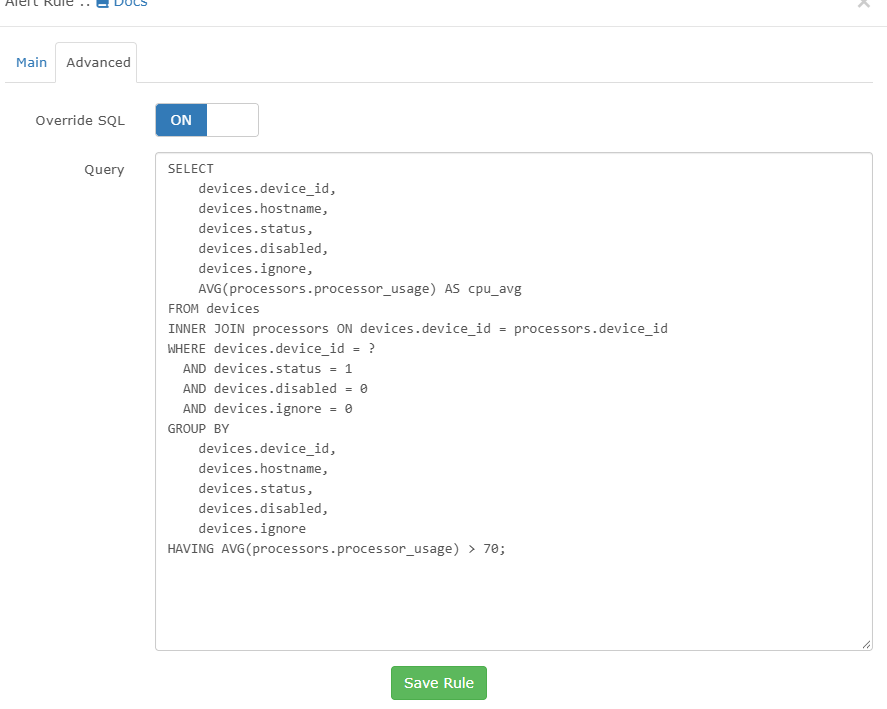
SELECT
    devices.device_id,
    devices.hostname,
    devices.status,
    devices.disabled,
    devices.ignore,
    AVG(processors.processor_usage) AS cpu_avg
FROM devices
INNER JOIN processors ON devices.device_id = processors.device_id
WHERE devices.device_id = ?
  AND devices.status = 1
  AND devices.disabled = 0
  AND devices.ignore = 0
GROUP BY
    devices.device_id,
    devices.hostname,
    devices.status,
    devices.disabled,
    devices.ignore
HAVING AVG(processors.processor_usage) > 70;
新增警報範本
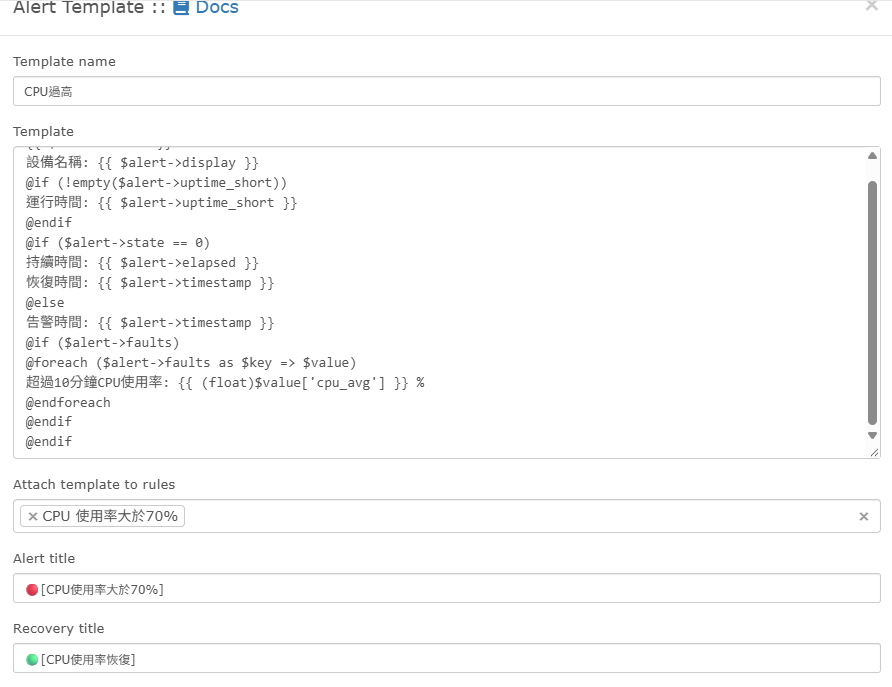
{{ $alert->title }}
設備名稱: {{ $alert->display }}
@if (!empty($alert->uptime_short))
運行時間: {{ $alert->uptime_short }}
@endif
@if ($alert->state == 0)
持續時間: {{ $alert->elapsed }}
恢復時間: {{ $alert->timestamp }}
@else
告警時間: {{ $alert->timestamp }}
@if ($alert->faults)
@foreach ($alert->faults as $key => $value)
超過10分鐘CPU使用率: {{ (float)$value['cpu_avg'] }} %
@endforeach
@endif
@endif
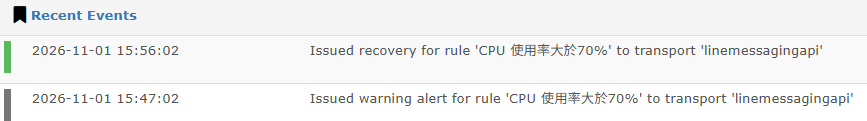
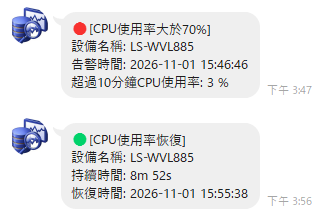
測試
這裡先調成>1%做測試
LibreNMS ICMP 監控警報
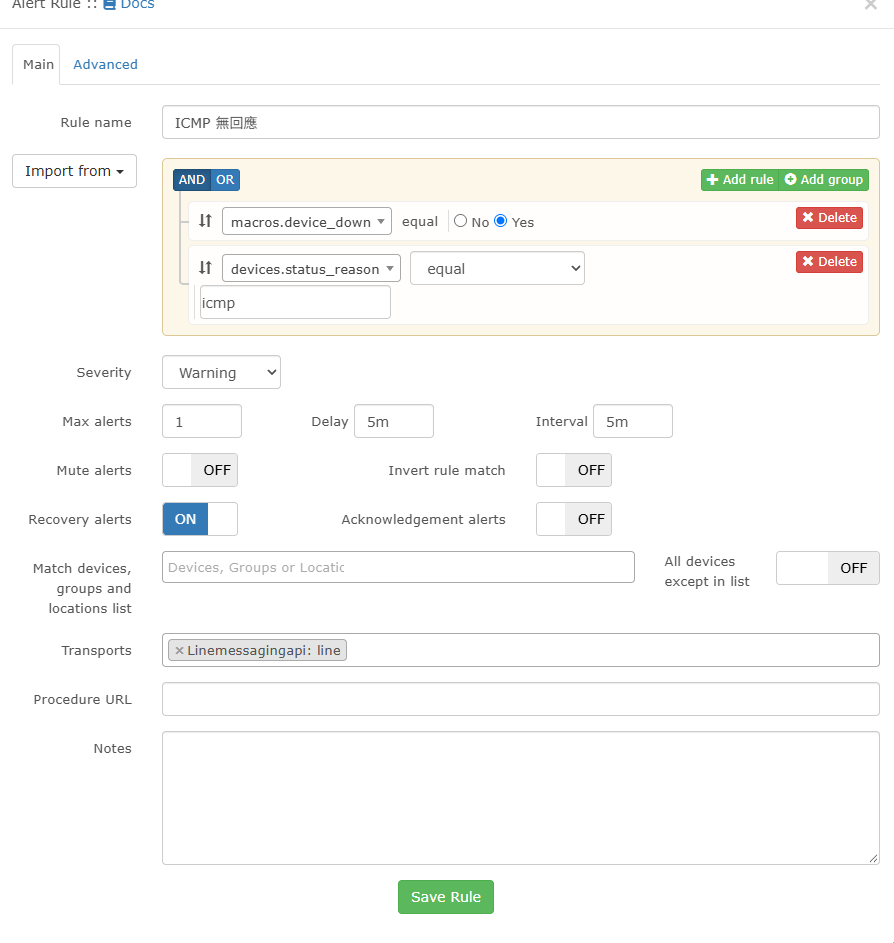
新增警報規則
若ICMP 5分鐘沒恢復則發送告警
Transport選擇要發送的位置
若不選擇設備則預設全部設備套用
新增警報範本
{{ $alert->title }}
設備名稱: {{ $alert->display }}
@if (!empty($alert->uptime_short))
運行時間: {{ $alert->uptime_short }}
@endif
@if ($alert->state == 0)
持續時間: {{ $alert->elapsed }}
恢復時間: {{ $alert->timestamp }}
@else
告警時間: {{ $alert->timestamp }}
@endif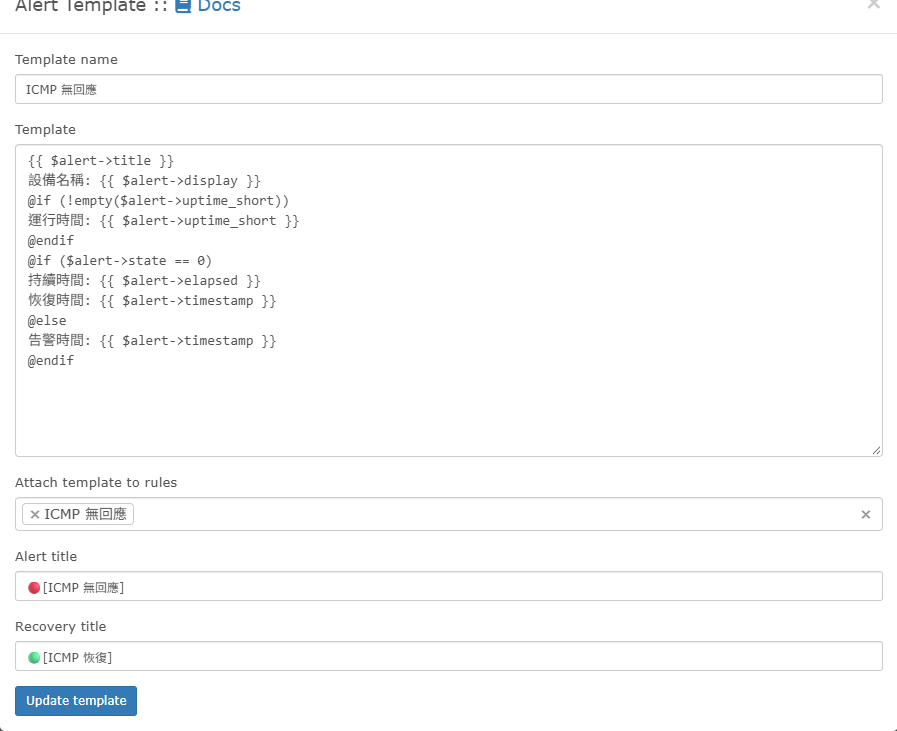
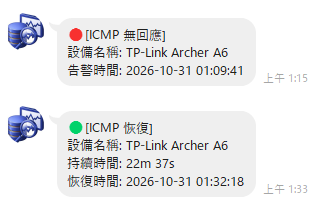
測試
測試告警
LibreNMS 自訂 LVM-Thin Pool 監控
/dev/mapper/vg-lv 掛載到 /data),它在作業系統中是一個標準的「掛載檔案系統」。LibreNMS 透過標準的 SNMP(HOST-RESOURCES-MIB)就能直接抓到這個掛載點的磁碟容量與使用率。local-lvm)。它本身沒有檔案系統,也沒有掛載到任何目錄上。因為它在系統中沒有 mount point,標準的 SNMP 走索引時根本看不到它,LibreNMS 自然就無法自動探索(Discovery)並畫出圖表。建立SNMP Extend 腳本
我的lvm-thin是使用USB外接硬碟,已經建立usb-lvm-thin
建立/etc/snmp/usb-lvm-thin,usb-lvm-thin修改成自已的Thin Pool
#!/bin/bash
percent=$(sudo /sbin/lvdisplay -m usb-lvm-thin 2>/dev/null | /bin/grep "Allocated pool data" | /usr/bin/awk '{print $4}' | /bin/sed 's/[.].*$//')

if [ -z "$percent" ]; then
    echo "0"
else
    echo "$percent"
fi
chmod +x /etc/snmp/usb-lvm-thin新增/etc/sudoers.d/snmpd-lvm,讓snmp能執行lvdisplay
Debian-snmp ALL=(ALL) NOPASSWD: /sbin/lvdisplay確認snmp程序能抓取資料
su -s /bin/bash Debian-snmp -c "/etc/snmp/usb-lvm-thin"/etc/snmp/snmpd.conf新增extend
extend lvmthin /etc/snmp/usb-lvm-thinservice snmpd restartCustom OID設定
確認已經建立OID,名稱統一為LVM-THIN,後續只要自訂LVM THIN OID都能統一套用
NET-SNMP-EXTEND-MIB::nsExtendOutLine."lvmthin".1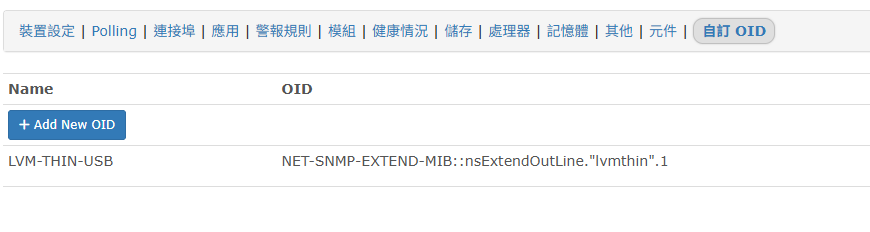
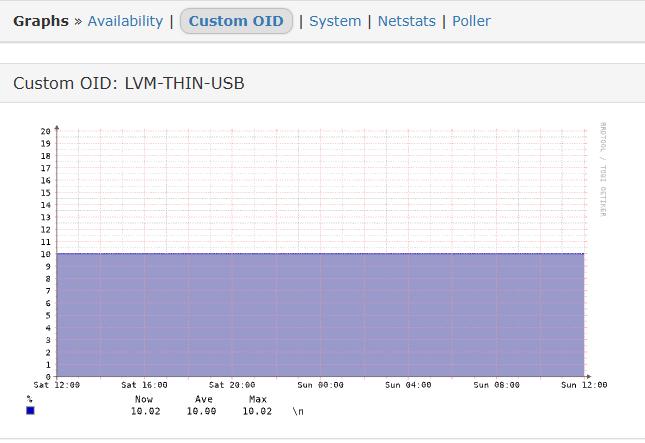
確認有顯示圖表
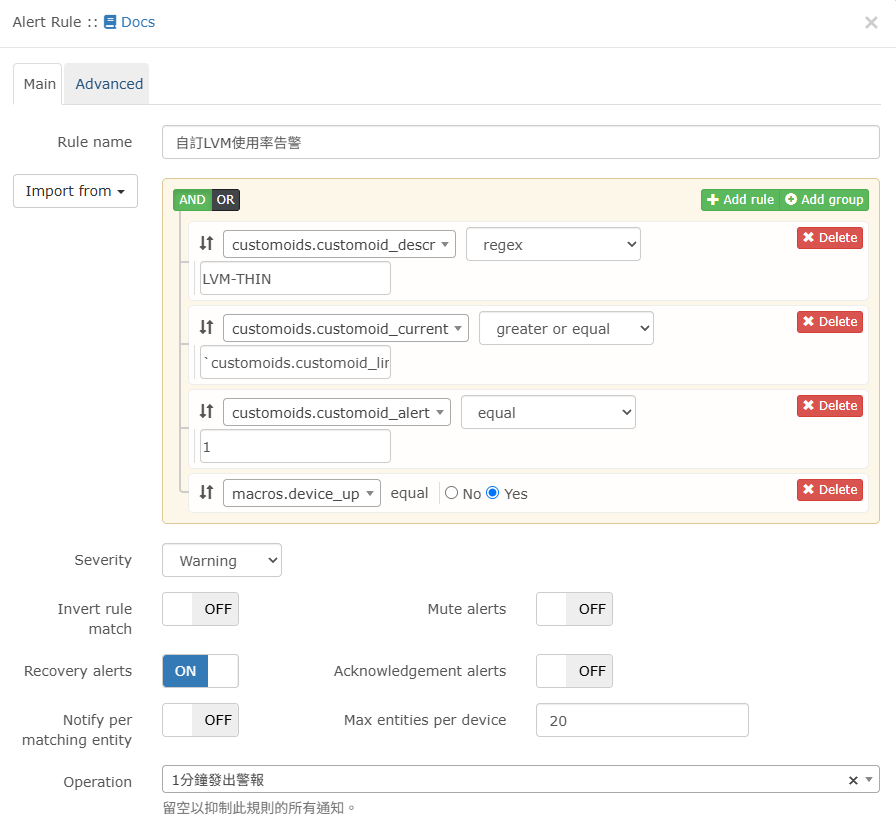
建立警報規則
選擇Create rule from collection,選擇CustomOID over warning limit
Add rule放在上面,讓descr匹配LVM-THIN
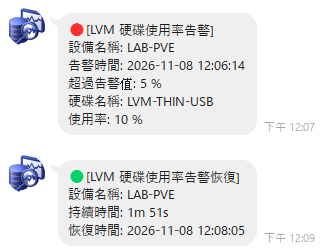
建立警報範本
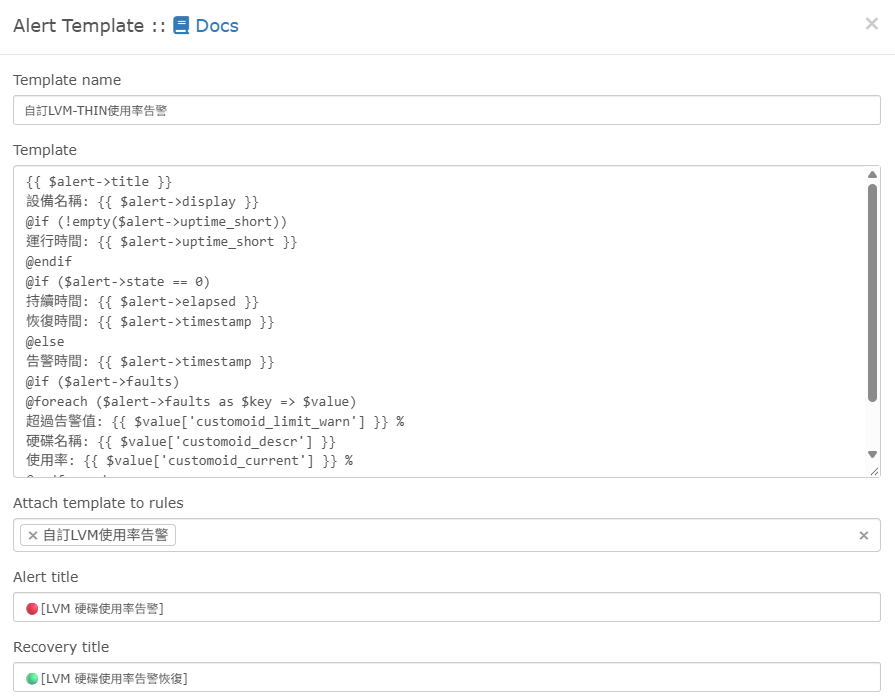
{{ $alert->title }}
設備名稱: {{ $alert->display }}
@if (!empty($alert->uptime_short))
運行時間: {{ $alert->uptime_short }}
@endif
@if ($alert->state == 0)
持續時間: {{ $alert->elapsed }}
恢復時間: {{ $alert->timestamp }}
@else
告警時間: {{ $alert->timestamp }}
@if ($alert->faults)
@foreach ($alert->faults as $key => $value)
超過告警值: {{ $value['customoid_limit_warn'] }} %
硬碟名稱: {{ $value['customoid_descr'] }}
使用率: {{ $value['customoid_current'] }} %
@endforeach
@endif
@endif
LibreNMS 自訂CPU溫度監控警報
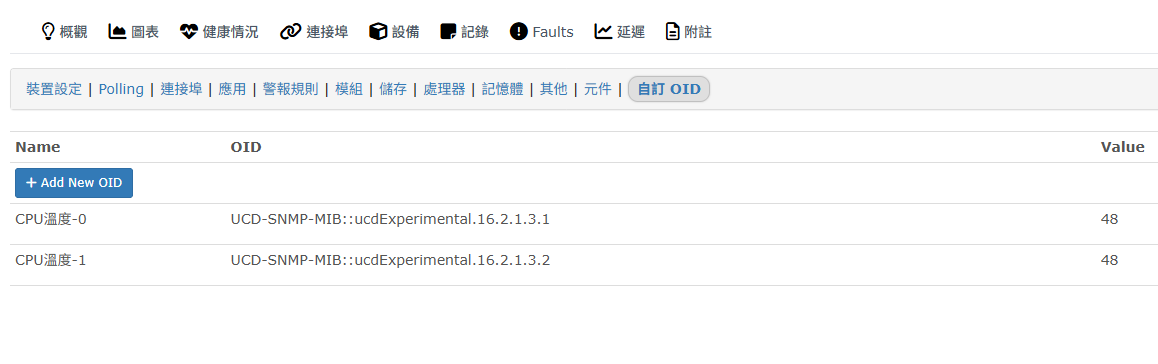
自訂OID
確認已經建立OID,名稱統一為CPU溫度,後續只要自訂CPU 監控OID都能統一套用
建立警報規則
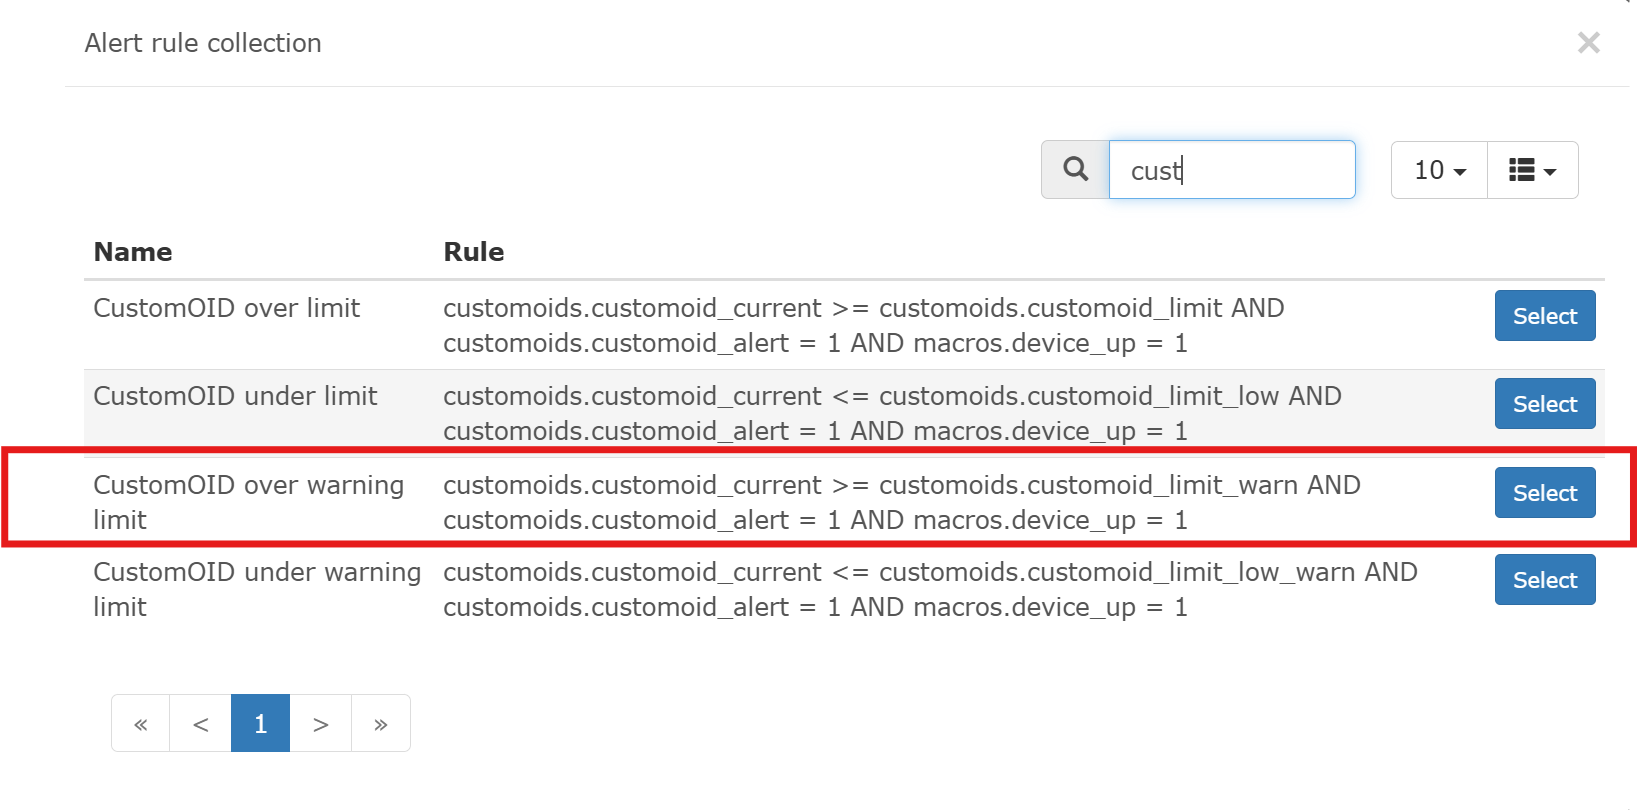
選擇Create rule from collection,選擇CustomOID over warning limit
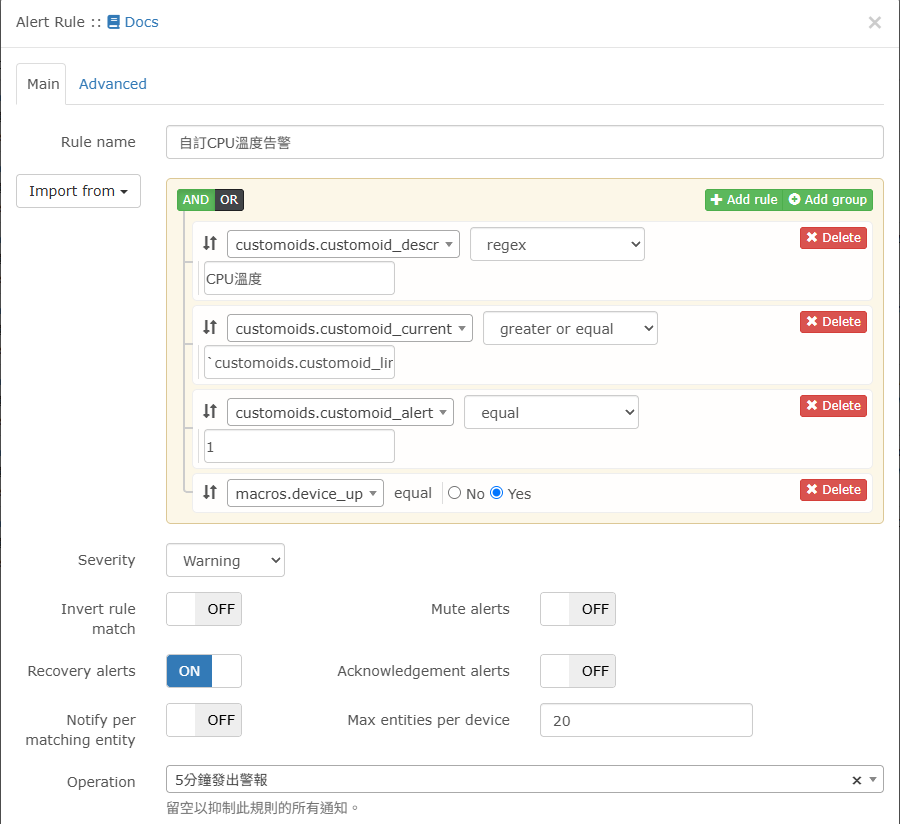
Add rule放在上面,讓descr匹配CPU溫度
建立警報範本
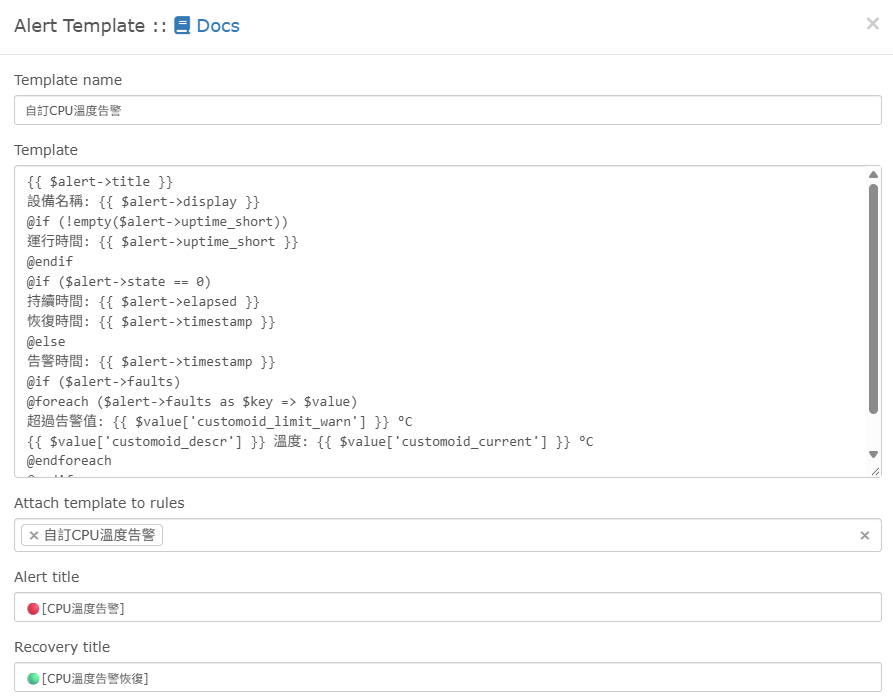
{{ $alert->title }}
設備名稱: {{ $alert->display }}
@if (!empty($alert->uptime_short))
運行時間: {{ $alert->uptime_short }}
@endif
@if ($alert->state == 0)
持續時間: {{ $alert->elapsed }}
恢復時間: {{ $alert->timestamp }}
@else
告警時間: {{ $alert->timestamp }}
@if ($alert->faults)
@foreach ($alert->faults as $key => $value)
超過告警值: {{ $value['customoid_limit_warn'] }} °C
{{ $value['customoid_descr'] }} 溫度: {{ $value['customoid_current'] }} °C
@endforeach
@endif
@endif
此為通用範例自行修改